
DeepSeek-OCR に縦書きの『どんぐりと山猫』の画像を読ませると、文章の最後のせりふだけを102回書き続けました(図1)。編集部では無料で使える OCR(画像の文字を読み取ってテキストにする技術)12種を、同じ日本語の文章を横書き・縦書き・スキャン風にした画像36枚で、2回ずつ(1つは1回)測定しました。処理のエラーなしに3つの条件すべてで誤り率が2%未満だったのは、国立国会図書館が公開している NDLOCR-Lite だけです。
DeepSeek-OCR は縦書きの宮沢賢治『どんぐりと山猫』で、文章の最後のせりふだけを102回書き続けた
- 読ませた画像(右上の一部)
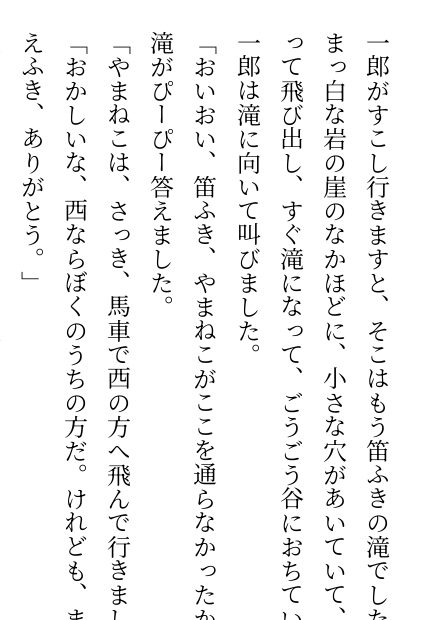
- 正解(画像の文章の冒頭。全365字)
- 一郎がすこし行きますと、そこはもう笛ふきの滝でした。笛ふきの滝というのは、まっ白な岩の崖のなかほどに、小さな穴があいていて、そこから水が笛のように鳴って飛び出し、すぐ滝になって、ごうごう谷におちているのをいうのでした。一郎は滝に向いて叫びま…
- DeepSeek-OCR の出力(冒頭の4行)
- 「おい、きのこ、やまねこが、ここを通らなかったかい。」
「おい、きのこ、やまねこが、ここを通らなかったかい。」
「おい、きのこ、やまねこが、ここを通らなかったかい。」
「おい、きのこ、やまねこが、ここを通らなかったかい。」
…
横書きでは12種のうち7つが誤り率2%未満でした。差が開いたのは縦書きです。DeepSeek-OCR は横書きの誤り率が1.00%でしたが、縦書きでは同じ文の繰り返しで大きく崩れました。
測った画像:同じ文章を横書き・縦書き・スキャン風にした36枚
測った画像は3種類。同じ文章を横書き・縦書き・スキャン風にした
横書き
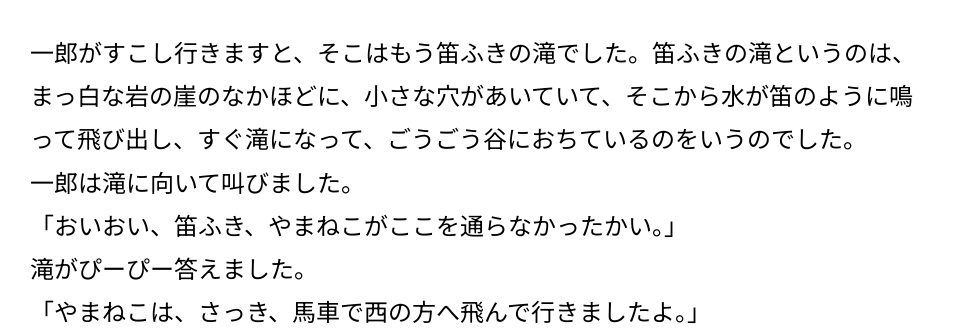
縦書き
スキャン風
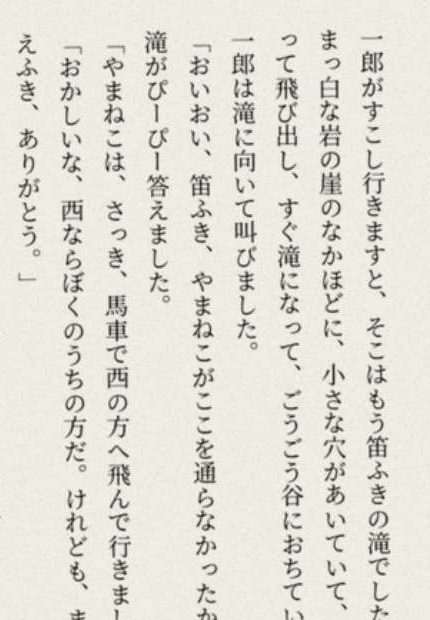
文章は著作権の切れた6作品から2か所ずつ選んだ281〜438字です。漢語の多い『山月記』、古い表記の多い『高瀬舟』、会話の多い『走れメロス』、ひらがなの多い童話『どんぐりと山猫』、近代の小説の『こころ』と『羅生門』を使いました。青空文庫(著作権の切れた作品などを公開している電子図書館)の原文をブラウザで組んで画像にしたため、正解は組んだ文字列そのものです。
実測表:エラーなしで3つの条件すべて2%未満だったのは NDLOCR-Lite だけ
表の数字は文字誤り率(%)で、小さいほど正確です。文字誤り率は正解の字数に対する、抜けた字・違う字・余計な字の数の割合です。同じ文を書き続けて余計な字が増えると、100%を超えます。空白と改行は数えず、句読点と括弧は数えました。
画像対応の言語モデル(画像を読み込んで文章で答えられる大規模言語モデル)では、Ollama(言語モデルを手元で動かす無料のソフトウェア)がエラーを返したか、15分で打ち切った画像がありました。その画像は除いて計算し、枚数を「エラー」として括弧に書いています。除いた画像はモデルごとに違うため、エラーのあるモデルの値は、そのままでは他と比べられません。2回の値が違う場合は/で並べました。表は縦書きの誤り率の低い順です。
| 名前 | 種類 | 横書き | 縦書き | スキャン風 | 1枚の処理時間 (参考) |
ライセンス |
|---|---|---|---|---|---|---|
| NDLOCR-Lite | OCR | 1.04% | 0.56% | 0.35% | 4.8秒 | CC BY 4.0(同梱の学習済みモデルは DINOv3 License も) |
| Qwen3-VL 8B(instruct 版) | 画像対応の言語モデル | 0.53% | 0.60%(エラー 4枚) | 1.78% | 1.9秒 | Apache-2.0 |
| GLM-OCR | 画像対応の言語モデル | 0.74% | 0.80/0.83%(エラー 1/2枚) | 1.41% | 0.6秒 | MIT |
| Qwen3-VL 30B-A3B(instruct 版) | 画像対応の言語モデル | 0.88% | 1.00%(エラー 4枚) | 1.99% | 1.6秒 | Apache-2.0 |
| Tesseract 5.5 | OCR | 5.80% | 2.60% | 2.74% | 2.3秒 | Apache-2.0 |
| Gemma 3 12B | 画像対応の言語モデル | 6.21% | 9.57% | 57.8% | 2.1秒 | Gemma Terms of Use |
| Gemma 4 12B | 画像対応の言語モデル | 5.40% | 45.8%(エラー 5枚) | 113.5%(エラー 3枚) | 2.1秒 | Apache-2.0 |
| PaddleOCR(PP-OCRv5) | OCR | 0.76% | 85.0% | 84.5% | 10.0秒 | Apache-2.0 |
| Mistral Small 3.2 24B(1回目のみ) | 画像対応の言語モデル | 5.98% | 89.1%(エラー 3枚) | 90.2% | 記録なし | Apache-2.0 |
| EasyOCR | OCR | 8.04% | 98.8% | 98.8% | 1.4秒 | Apache-2.0 |
| Qwen2.5-VL 7B | 画像対応の言語モデル | 0.88/0.83% | 284.2/269.3% | 5.96/6.35% | 1.4秒 | Apache-2.0 |
| DeepSeek-OCR | 画像対応の言語モデル | 1.00% | 392.7/461.5% | 330.9% | 0.8秒 | MIT |
処理時間は OCR を CPU 16個分(Docker の --cpus 16)で、画像対応の言語モデルを GPU(画像処理用の演算装置。データセンター向けの NVIDIA H200)1基で測った、1枚あたりの中央値です。NDLOCR-Lite だけは36枚をまとめて処理した時間を36で割った値で、モデルの読み込みの時間も含みます。機材が違うため、目安として見てください。
NDLOCR-Lite は、国立国会図書館が公開している OCR です。配布ページには GPU を必要とせず、一般的な家庭用のパソコンで動くと書かれています(NDLOCR-Lite)。編集部も CPU だけで動かしました。Qwen3-VL の2つと GLM-OCR は、出力があった画像では3つの条件すべてで2%未満でしたが、縦書きの一部の画像でエラーが起きました(後述)。
縦書き:横書きで2%未満だった7つのうち3つが、縦書きでは80%を超えた
縦書きの12枚すべてで出力があったもののうち、誤り率が最も低かったのは NDLOCR-Lite(0.56%)
縦書きで大きく崩れた主な原因は3つありました。
- 同じ文の繰り返し:DeepSeek-OCR は12枚中7〜8枚、Qwen2.5-VL 7B は4枚で、同じ文や語句を繰り返し、出力が正解の2倍を超えました。
- 行の並び順:PaddleOCR は各行の文字を読めていましたが、行を左から順に並べて出力しました。縦書きは右の行から読むため、文章の順が入れ替わります。出力に付く行の位置を使って右から並べ直すと、誤り率は85.0%から11.5%に下がりました(図の灰色)。
- 文字を読めない:EasyOCR は12枚で合計362字しか出力せず、正解の字の9割以上が抜けました。Mistral Small 3.2 24B は、意味の通らない文字の並びを出力しました。
Gemma 4 12B は、12枚のうち5枚で Ollama がエラーを返し、出力があった7枚でも誤り率が45.8%でした。
Tesseract は縦書き用の学習データ(jpn_vert)を指定して、縦書き2.60%、スキャン風2.74%でした。横書きか縦書きかは編集部が画像ごとに指定しています。両方が混ざった文書では、どちらの学習データを使うかを先に決める必要があります。
スキャン風:5つが誤り率3%未満で、最も低かったのは NDLOCR-Lite
スキャン風の画像で誤り率が3%未満だったのは5つ。最も低かったのは NDLOCR-Lite(0.35%)
スキャン風の画像は縦書きの画像を傾け、ぼかし、雑音を足した物です。誤り率の低いもののうち、12枚すべてで出力があった NDLOCR-Lite と Tesseract は、縦書きとの差が0.3ポイント以内でした。
繰り返しは同じ文章でも画像によって起きたり起きなかったりしました。Qwen2.5-VL 7B は縦書きで4枚が繰り返しになりましたが、スキャン風では1枚もなく、誤り率は5.96%と6.35%でした。反対に Gemma 3 12B は縦書きで9.57%でしたが、スキャン風の1枚で同じ文を繰り返し、誤り率57.8%のうち49ポイント分が余計な字でした。
横書き:7つが誤り率2%未満で、差は小さかった
横書きで誤り率が2%未満だったのは7つ(0.53〜1.04%)
横書きで2%未満だったのは、Qwen3-VL 8B(0.53%)、GLM-OCR(0.74%)、PaddleOCR(0.76%)、Qwen2.5-VL 7B(0.83〜0.88%)、Qwen3-VL 30B-A3B(0.88%)、DeepSeek-OCR(1.00%)、NDLOCR-Lite(1.04%)です。12枚の正解は合計4,314字で、0.5ポイントの差は約22字にあたります。12枚では、この差が画像の選び方によるものかを分けられないため、7つに順位は付けていません。
Tesseract は横書きで5.80%と、縦書き(2.60%)より誤りが多くなりました。1回目の誤り250字のうち170字は2枚の画像に集中していて、文のまとまりが別の位置に移っていました(行の並び順の誤り)。ほかに、『羅生門』の「鴉」を「狼」と読むなど、画数の多い漢字の読み違いもありました。
画像対応の言語モデルでは、Ollama がエラーを返す画像があった
画像対応の言語モデルは編集部の GPU サーバー(NVIDIA H200)で Ollama から動かしました。同じ画像で、2回とも Ollama がエラーを返すことがありました。Ollama の記録には GPU の処理の異常を示すメッセージが出ていましたが、家庭用の GPU で同じことが起きるかは確かめていません。表に載せた測定では、横書きの画像でエラーは起きませんでした。
| 名前 | 縦書き | スキャン風 |
|---|---|---|
| Qwen3-VL 8B(instruct 版) | 4枚(2回とも同じ画像) | 0枚 |
| Qwen3-VL 30B-A3B(instruct 版) | 4枚(8B と同じ4枚) | 0枚 |
| GLM-OCR | 1回目1枚、2回目2枚 | 0枚 |
| Gemma 4 12B | 5枚(2回とも同じ画像) | 3枚(2回とも同じ画像) |
| Mistral Small 3.2 24B | 3枚(1回目。うち1枚は15分で打ち切り) | 0枚 |
Mistral Small 3.2 24B は、2回目の測定で15分を超えて打ち切る画像が続いたため、2回目を途中で止め、1回目の値だけを載せました。
Qwen3-VL は Ollama で既定の版が、考える過程を書いてから答える版(思考型)でした。考える過程を止める指定を送っても、出力の上限に達して答えが空になる画像が多く出ました。答えが空だった画像は、1回あたり36枚のうち、8B が26枚(うち4枚はエラー)、30B が25枚です。表には考える過程を書かない版(instruct 版)を載せました。
測定の条件
測定の条件の詳細を開く
画像:青空文庫の原文から、ルビ(ふりがな)と入力者の注記を除き、各作品の本文の10%と50%の地点から段落の切れ目で2か所を選びました(2026年11月8日)。罫線だけの行と章の番号の行は除きました。作品は青空文庫の図書カード(作品ごとの紹介ページ)の番号で、山月記624、高瀬舟45245、走れメロス1567、どんぐりと山猫43752、こころ773、羅生門127です。横書きは Noto Sans JP の24px、縦書きは Noto Serif JP の24px(writing-mode: vertical-rl)で、行間は1.8、白地に黒です。Chromium で組んで画像にしました。スキャン風は縦書きの画像を0.8度傾け、ぼかし(半径0.6)と雑音(標準偏差8)を加え、70%に縮めてから戻し、生成り色の地にして JPEG の品質55で保存した物です(雑音の乱数の種は20261108)。『高瀬舟』は新字新仮名(今の字体と仮名遣い)の版を使い、『山月記』で外字(文字コードに無い字)として注記されていた字は「袁傪」に戻しました。
誤りの数え方:正解と出力を NFKC(全角と半角などの表記をそろえる Unicode の正規化)でそろえ、空白と改行を除いてから、文字単位の編集距離(抜けた字・違う字・余計な字の数)を正解の字数で割りました。読みには直していないため、漢字とかなの書き方の違いも誤りに数えます。出力全体を包む Markdown(文書の書式の記法)のコードの囲みだけは外しました。
OCR:Intel Xeon Platinum 8558 の CPU 16個分に制限した(--cpus 16)Docker の中で動かしました。
- NDLOCR-Lite:ndl-lab/ndlocr-lite のコミット df90b22
- Tesseract 5.5.0:学習データは tessdata_best。横書きは jpn、縦書きとスキャン風は jpn_vert を指定
- PaddleOCR 3.7.0(PaddlePaddle 3.3.1):
lang="japan"、PP-OCRv5(PaddleOCR の第5世代のモデル)の server 版の検出と認識。use_doc_orientation_classify=False、enable_mkldnn=False - EasyOCR 1.7.2:文字の位置の検出は craft_mlt_25k、認識は日本語のモデル(japanese_g2)
CPU で動く4つは、2回の出力が全画像で同じでした。Tesseract はページの区切り方の設定(--psm 5、縦書きの1つのまとまりとして読む)も試し、縦書き2.64%、スキャン風2.69%と、既定の設定とほぼ同じでした。
画像対応の言語モデル:Ollama 0.40.15 を NVIDIA H200 1基で動かしました。温度(出力のばらつきの設定。0で最も確率の高い語を選ぶ)は0、シード値(乱数の種)は42、出力の上限は2,048トークン、コンテキスト長(1回に扱える入力と出力の長さ)は8,192トークンです。依頼文は「この画像の文字を、書かれている順にすべてそのまま書き出してください。説明や前置きは書かないでください。」で、OCR 用の2つだけは配布ページの使い方にある依頼文(GLM-OCR は「Text Recognition:」、DeepSeek-OCR は「Free OCR.」)を使いました。
| 名前 | Ollama のタグ(モデルの種類と大きさを指す名前) | ID |
|---|---|---|
| Qwen3-VL 8B(instruct 版) | qwen3-vl:8b-instruct |
70e58e37beb1 |
| GLM-OCR | glm-ocr |
89d735dd9c07 |
| Qwen3-VL 30B-A3B(instruct 版) | qwen3-vl:30b-a3b-instruct |
9b053ed92b6a |
| Gemma 3 12B | gemma3:12b |
b92b218582c5 |
| Gemma 4 12B | gemma4:12b |
6114515d63c1 |
| Mistral Small 3.2 24B(1回目のみ) | mistral-small3.2:24b |
5a408ab55df5 |
| Qwen2.5-VL 7B | qwen2.5vl:7b |
5ced39dfa4ba |
| DeepSeek-OCR | deepseek-ocr |
0e7b018b8a22 |
ID は測定に使った計算機で ollama list を実行して記録しました(2026年11月9日)。ライセンスは各配布ページの表示です(2026年11月9日に確認)。商用で使えるかは各ライセンスの全文で確かめる必要があります。Gemma 3 は Google の独自の利用規約(Gemma Terms of Use)です。
エラーと思考型の版:エラーは、Ollama が HTTP 500 を返したものと、15分で応答が無く打ち切ったもの(Mistral Small 3.2 24B の1回目の1枚)です。Ollama のコンテナの記録には「CUDA error: an illegal instruction was encountered」が44回出ていましたが、HTTP 500 の1回ずつとの対応は取っていません。Qwen3-VL の既定のタグは qwen3-vl:8b と qwen3-vl:30b で、think: false(思考を止める指定)を送って測りました。表の instruct 版のタグは qwen3-vl:8b-instruct と qwen3-vl:30b-a3b-instruct です。
繰り返しの数え方:出力の字数が正解の2倍を超えた画像を数えました。該当した出力は、どれも同じ文や語句が続いていました。
この表で分からないこと
- 実際にスキャンした紙や、スマートフォンで撮った写真での精度。今回の画像は文字を画面で組んで作り、スキャン風も加工で作りました。
- 手書きの文字、表、段組み、ルビの付いた文章、古い活字の資料での精度。
- 画像の数による誤差。条件ごとに12枚(正解は合計4,314字)で、2回の測定で分かるのは実行のたびの揺れだけです。
- エラーのあったモデルを、同じ画像の組で比べた時の差。表の値はエラーの画像を除いた残りで計算しています。
- 出力の上限を変えた時の値。100%を超える誤り率と繰り返しの回数は、出力の上限(2,048トークン)で決まっています。
- 繰り返しを抑える設定を使った時の結果。今回は試していません。
- 字体と文字の大きさを変えた時の精度。字体は Noto Sans JP と Noto Serif JP、大きさは24pxの1通りだけです。
- 依頼文を変えた時の精度。DeepSeek-OCR の配布ページには、Markdown に変換する依頼文も載っていますが、試していません。
- 家庭用の GPU での速さと、Ollama のエラーが起きるか。
- PDF のまま読ませた時の結果。今回は画像だけを測りました。
- クラウドの OCR サービスや ChatGPT との比較。
この表は毎月再測定し、新しいモデルが出たら同じ画像で追加します。無料の文字起こしモデルは文字起こしの実測表、自社のパソコンで動かす言語モデルはローカルLLMの実測表にまとめました。
よくある質問
日本語の無料OCRで、誤りが少ないのはどれですか。
編集部が日本語の画像36枚で測定した範囲(2026年11月)では、国立国会図書館が公開している NDLOCR-Lite の文字誤り率が、横書き1.04%、縦書き0.56%、スキャン風0.35%でした。12種のうち、処理のエラーなしに3つの条件すべてで2%未満だったのは NDLOCR-Lite だけです。編集部は GPU を使わず、CPU だけで動かしました。横書きだけなら、7つが2%未満でした。
DeepSeek-OCR は日本語の縦書きを読めますか。
今回の測定では、横書きの文字誤り率は1.00%でしたが、縦書きは392.7%と461.5%(2回の値)、スキャン風は330.9%でした。縦書きの12枚のうち7〜8枚で、同じ文や語句を繰り返し、出力が正解の2倍を超える長さになりました。文字誤り率は余計な字も数えるため、100%を超えます。依頼文は配布ページにある「Free OCR.」を使い、ほかの依頼文は試していません。
PaddleOCR は縦書きに対応していますか。
PaddleOCR(PP-OCRv5)は縦書きの各行の文字を読めていましたが、行を左から順に並べて出力したため、縦書きの文字誤り率は85.0%でした。縦書きは右の行から読みます。出力に付く行の位置を使って右から並べ直すと、11.5%になりました。並べ直した後も、字の抜けが残りました。
クラウドの OCR や ChatGPT と比べるとどうですか。
今回はクラウドのサービスを測っていません。測ったのは、自社のパソコンやサーバーで動く無料の OCR と、Ollama で動く画像対応の言語モデルだけです。