
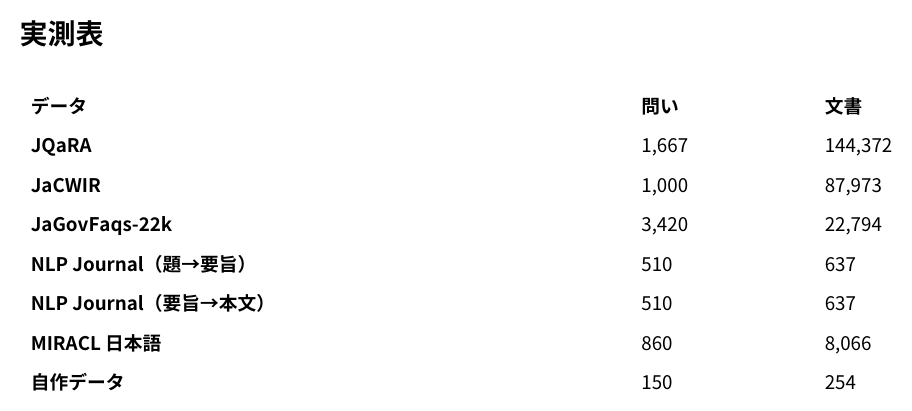
社内の PDF を LLM に読ませる方法は、大きく 2 つあります。ページから文字を取り出して渡す方法と、ページを画像にして VLM(画像も入力できる LLM)に渡す方法です。編集部では、AIコンパスで公開している実測表(測定の結果をまとめた記事)の表を PDF にし、そのページを渡して「MIRACL 日本語の文書は何件あるか」と質問しました。MIRACL は検索の評価に使う公開データセットで、正解は 8,066 件です。
罫線の無い表で「MIRACL 日本語の文書は何件あるか」と聞くと、ページを文字で渡した時は 13 モデル中 6 モデル(LibreOffice の PDF)と 7 モデル(Chromium の PDF)が隣の列の 860 と答えた。画像で渡すと 13 モデルとも 8,066
渡したページの画像(表の部分を切り抜いた。LibreOffice で作った PDF の 2 ページ目)
- 同じページを pdfplumber で文字にした時の、見出しの行と答えの行
データ 問い 文書MIRACL 日本語 860 8,066
| モデル | 文字・LibreOffice | 文字・Chromium | 画像・LibreOffice | 画像・Chromium |
|---|---|---|---|---|
| Gemma 4 26B | ○ 8,066 | ○ 8,066 | ○ 8,066 | ○ 8,066 |
| Qwen3.8 27B | ○ 8,066 | ○ 8,066 | ○ 8,066 | ○ 8,066 |
| Gemma 4 31B | ○ 8,066 | ○ 8,066 | ○ 8,066件 | ○ 8,066 |
| Qwen3.5 27B | ○ 8,066 | ○ 8,066 | ○ 8,066 | ○ 8,066 |
| Qwen3-VL 32B Instruct | ○ 8,066 | ○ 8,066 | ○ 8,066 | ○ 8,066 |
| Gemma 4 12B | ○ 8,066 | × 860 | ○ 8,066 | ○ 8,066 |
| Qwen3.5 9B | ○ 8,066 | × 860 | ○ 8,066 | ○ 8,066 |
| Qwen3-VL 8B Instruct | × 860 | × 860 | ○ 8,066 | ○ 8,066 |
| Qwen2.5-VL 7B | × 860 | × 860 | ○ 8,066 | ○ 8,066 |
| Qwen3-VL 30B-A3B Instruct | × 860 | × 860 | ○ 8,066 | ○ 8,066 |
| Mistral Small 3.2 24B | × 860 | ○ 8,066 | ○ 8,066 | ○ 8,066 |
| Gemma 3 27B | × 860 | × 860 | ○ 8,066 | ○ 8,066 |
| Gemma 3 12B | × 860 | × 860 | ○ 8,066 | ○ 8,066 |
ページから取り出した文字で渡すと、LibreOffice で作った PDF では 13 モデル中 6 モデルが 860 と答えました。860 は同じ行の「問い」の列の値です。取り出した文字では、見出しの行が「データ 問い 文書」の 3 語、答えの行が「MIRACL 日本語 860 8,066」の 4 語になります。行の語を前から順に見出しへ当てはめると、860 が「文書」の位置に来ます。6 モデルが 860 と答えたのは、このためと考えています(推定)。同じページを画像で渡すと、13 モデルとも 8,066 と答えました。Chromium で作った PDF でも、文字では 7 モデルが 860 と答え、画像では 13 モデルとも正解しています。
編集部では、こうした違いがどのくらいの頻度で起きるかを、Ollama で動かせる無料の 13 モデルで測りました。PDF の 1 ページを次の 4 通りで渡し、同じ 186 問(本文の問い 123・表の問い 63)の正答率を比べています。渡すのは、問いの答えが書かれたページ(以下、根拠のページ)だけです。
- 画像:ページを 150 dpi の画像にして渡します。100 dpi と 200 dpi も測りました。
- 文字:ページから pdfplumber(PDF の文字を取り出す Python のライブラリ)で取り出した文字を渡します。
- スキャン風の画像:150 dpi の画像に、傾き・ぼかし・ノイズ・JPEG の圧縮を加えて、紙をスキャンした画像に似せたものを渡します。
- OCR の文字:スキャン風の画像を、OCR のモデル(glm-ocr)で文字にして渡します。
問いと PDF は、PDF 変換の実測表と同じ原稿から作りました。同じ原稿を LibreOffice と Chromium の 2 通りで PDF にし、2 種類の PDF のそれぞれで全問を測っています。同じ PDF を 2 回測ったのではなく、PDF の作り方を変えて 2 回測りました。表と図の「a〜b」は、1 つのモデルの、2 種類の PDF での値の小さい方と大きい方です。複数のモデルにまたがる値の幅は「a% から b%」と書きます。
2 つの渡し方の差は、同じ問いで渡し方だけを変えて比べる検定で調べました。2 種類の PDF のどちらでも検定で差が出て、向きも同じだった時だけ「どちらの PDF でも多かった」「どちらの PDF でも少なかった」と書きます。片方の PDF だけで差が出た時は、そのモデルの名前を挙げて「片方の PDF だけ」と書きます。どちらの PDF でも差が出なかった時は、値に開きがあっても「差があるとは言えない」と書きます(方法は「測定の条件」の節)。
画像で渡すか文字で渡すかで、正答の数にどちらの PDF でも差が出たのは 13 モデル中 4 モデルでした。画像の方が多かったのは Qwen2.5-VL 7B、文字の方が多かったのは Gemma 3 の 2 モデルと Mistral Small 3.2 24B です。画像の解像度を 100 dpi に下げると、Gemma 4 の 26B と 31B は、ほぼ全問に「不明」と答えました。 要点は次のとおりです。根拠の数字は後の節にあります。
- 画像の正答率:150 dpi の画像で、どちらの PDF でも 90.9% 以上だったモデルが 8 つありました(最も高い値は 97.8%)。Gemma 3 の 2 モデルは 46.8% から 63.4% です。
- 取り出した文字で根拠が見つからない問い:pdfplumber で取り出した文字に、根拠(本文の問いは答えが書かれた文、表の問いは行見出し・答えのセル・列見出し)がそのままの形で見つからない問いがありました。2 段組み・縦書き・セルの中で折り返した表の問いで、LibreOffice の PDF で 29 問、Chromium の PDF で 30 問です。これらの問いでは、文字で渡した時の正答率が 13 モデルとも 73.3% 以下でした。画像では 5 モデルがどちらの PDF でも 80% 以上です(この分け方では検定していません)。
- 解像度:100 dpi では 4 モデルの正答が、150 dpi よりどちらの PDF でも少なくなりました。200 dpi と 150 dpi で、どちらの PDF でも差が出たモデルはありません。200 dpi は、Qwen3-VL・Qwen3.5・Qwen3.8 で入力のトークン数が 150 dpi の約 1.7 倍です。
- Gemma 4 の「不明」:100 dpi の画像を 150 dpi の画素数へ拡大して渡すと、Gemma 4 の 3 モデルは 186 問中 177 問から 182 問に正解しました(LibreOffice の PDF で測定。150 dpi では 180 問から 181 問)。読める情報は増えていないので、原因は、画素数の少ない画像を少ないトークンにして読む処理にあると考えています(推定)。
- スキャン風の画像:加工前の画像と比べて、正答の数にどちらの PDF でも差が出たモデルはありませんでした。スキャン風の画像より OCR の文字の方が正答がどちらの PDF でも多かったのは、Gemma 3 の 2 モデルと Mistral Small 3.2 24B です。画像と文字の比較で文字の方が多かった 3 モデルと同じです。
画像と文字:正答の数にどちらの PDF でも差が出たのは 13 モデル中 4 モデル
画像で渡した時の方が正答がどちらの PDF でも多かったモデルは 13 モデル中 1 モデル(Qwen2.5-VL 7B)、文字で渡した時の方がどちらの PDF でも多かったモデルは 3 モデル(Gemma 3 12B・Gemma 3 27B・Mistral Small 3.2 24B)
行は、画像で渡した時の正答率(2 種類の PDF の小さい方)が高い順に並べています。モデルどうしの差は検定していないため、順位表としては使えません。値の表は「測定の条件」の節にあります。
画像でどちらの PDF でも 90.9% 以上だった 8 モデルは、文字で渡しても 84.4% 以上でした。この 8 モデルのうち 7 モデルは、画像と文字で、どちらの PDF でも差があるとは言えません。Gemma 4 26B は、Chromium の PDF だけで画像の方が正答が多い結果でした(LibreOffice の PDF では差があるとは言えません)。Gemma 3 の 2 モデルと Mistral Small 3.2 24B は、文字では 86.6% から 91.4%、画像では 46.8% から 75.8% です。Qwen2.5-VL 7B は逆に、画像の 84.9〜86.6% に対して、文字では 68.8〜73.7% でした。このモデルは、PDF にする前の原稿の文字をそのまま渡した場合も 79.6% で、原稿の全文で 80% を下回ったのは 13 モデル中このモデルだけです(検定はしていません)。
取り出した文字で根拠が見つからない問い:文字で渡した時の正答率は 13 モデルとも 73.3% 以下(検定していない)
取り出した文字で根拠が見つからない問いでは、文字で渡した時の正答率が 13 モデルとも 73.3% 以下。画像ではどちらの PDF でも 80% 以上のモデルが 5 モデル(検定していない)
pdfplumber で取り出した文字(空白を除いて照合)に、根拠がそのままの形で見つからない問いだけを集計しました。内訳は、LibreOffice の PDF が 2 段組み 14 問・縦書き 9 問・セルの中で折り返した表 6 問、Chromium の PDF が 2 段組み 15 問・縦書き 9 問・セルの中で折り返した表 6 問です。2 段組みのページを 1 ページ確認すると、取り出した文字では左右の段の行が混ざって並んでいました。画像でどちらの PDF でも 80% 以上だった 5 モデル(Gemma 4 26B・Gemma 4 31B・Qwen3-VL 32B Instruct・Qwen3-VL 8B Instruct・Qwen3.8 27B)は、同じ問いを文字で渡すと 48.3% から 73.3% でした。
この分け方は測定を始める前に決めましたが、問いの数が少ないため検定はしていません。全 186 問の検定で、画像と文字に差があるとは言えなかったモデルでも、文書のレイアウトによっては、渡し方で正答が変わる可能性があります。
解像度:100 dpi の画像で、Gemma 4 の 3 モデルと Qwen3-VL 30B-A3B Instruct の正答が、150 dpi よりどちらの PDF でも少なかった
100 dpi の画像で、150 dpi より正答がどちらの PDF でも少なかったモデルは 4 モデル(Gemma 4 12B・Gemma 4 26B・Gemma 4 31B・Qwen3-VL 30B-A3B Instruct)。200 dpi と 150 dpi で、どちらの PDF でも差が出たモデルは 0(13 モデル中)
100 dpi の画像(A4 で 827 × 1,170 画素)では、Gemma 4 26B は 186 問中 185〜186 問、Gemma 4 31B は 179〜184 問で「不明」と答えました。同じ 100 dpi の画像で、Qwen3-VL 32B Instruct の正答率は 91.4〜95.7% なので、画像が読めないほど粗いわけではありません。Gemma 4 12B は 68.3〜84.4% でした。
モデルが読んだ入力のトークン数は、モデルごとに次のとおりです。
dpi を上げると入力のトークン数が増えたモデルは 10 モデル。変わらなかったのは 3 モデル(Mistral Small 3.2 24B・Gemma 3 27B・Gemma 3 12B)
| モデル | 画像(100 dpi) | 画像(150 dpi) | 画像(200 dpi) | 文字(pdfplumber) |
|---|---|---|---|---|
| Gemma 4 26B | 492 | 1,046 | 1,176 | 660 |
| Qwen3.8 27B | 1,045 | 2,228 | 3,879 | 678 |
| Gemma 4 31B | 492 | 1,046 | 1,176 | 660 |
| Qwen3.5 27B | 1,045 | 2,228 | 3,879 | 678 |
| Qwen3-VL 32B Instruct | 1,141 | 2,233 | 3,884 | 736 |
| Gemma 4 12B | 492 | 1,046 | 1,176 | 660 |
| Qwen3.5 9B | 1,045 | 2,228 | 3,879 | 678 |
| Qwen3-VL 8B Instruct | 1,141 | 2,233 | 3,884 | 736 |
| Qwen2.5-VL 7B | 1,356 | 2,868 | 4,124 | 747 |
| Qwen3-VL 30B-A3B Instruct | 1,141 | 2,233 | 3,884 | 736 |
| Mistral Small 3.2 24B | 1,616 | 1,616 | 1,616 | 1,265 |
| Gemma 3 27B | 349 | 349 | 349 | 657 |
| Gemma 3 12B | 349 | 349 | 349 | 657 |
Gemma 4 は 100 dpi で約 490 トークン、150 dpi で約 1,050 トークンです。画像の画素数に応じて、読むトークンの数が変わっています。そこで、100 dpi の画像を 150 dpi と同じ画素数へ拡大して渡す測定を追加しました。拡大しても読める情報は増えません。結果を見る前に、読み方を次のように決めました。拡大で正答が戻れば、原因は画素数の少ない画像を少ないトークンにして読む処理にある。戻らなければ、100 dpi に縮めた時点で読める情報が失われた。
Gemma 4 の 3 モデルが正解した問いの数は、100 dpi で 0 問から 157 問、100 dpi を拡大した画像で 177 問から 182 問、150 dpi で 180 問から 181 問(LibreOffice の PDF・186 問)
| モデル | 100 dpi | 拡大した画像 | 150 dpi | トークン数(100 dpi・拡大・150 dpi) |
|---|---|---|---|---|
| Gemma 4 26B | 1/186(0.5%) | 177/186(95.2%) | 181/186(97.3%) | 492・1,046・1,046 |
| Gemma 4 31B | 0/186(0.0%) | 182/186(97.8%) | 180/186(96.8%) | 492・1,046・1,046 |
| Gemma 4 12B | 157/186(84.4%) | 180/186(96.8%) | 180/186(96.8%) | 492・1,046・1,046 |
拡大した画像では、3 モデルとも 150 dpi に近い数の問いに正解し、入力のトークン数も 150 dpi と同じ 1,046 でした。決めておいた読み方に従うと、100 dpi で読めなかった原因は画素数の少ない画像の扱いにあり、100 dpi の画像にも答えに必要な情報は残っていたことになります。Gemma 4 で解像度の低い画像を読ませる時は、拡大してから渡すと正答が戻る可能性があります(推定。拡大した画像は LibreOffice の PDF だけで測りました)。
200 dpi では、150 dpi と比べて、正答の数にどちらの PDF でも差が出たモデルはありませんでした。一方、入力のトークン数は Qwen3-VL・Qwen3.5・Qwen3.8 で、約 2,230 から約 3,880 に増えます。Gemma 3 と Mistral Small 3.2 24B は、dpi を変えてもトークン数が変わりませんでした(349 と 1,616)。この 3 モデルは、画像を決まった大きさに縮めてから読んでいるためと考えています(推定)。
スキャン風の画像:加工前の画像と差が出たモデルは 0、OCR の文字の方が正答が多かったのは 3 モデル(どちらの PDF でも)
スキャン風の画像と比べて、OCR の文字の方が正答がどちらの PDF でも多かったモデルは 13 モデル中 3 モデル(Gemma 3 12B・Gemma 3 27B・Mistral Small 3.2 24B)。加工前の画像とスキャン風の画像で、どちらの PDF でも差が出たモデルは 0
スキャン風の画像は、150 dpi の画像に 0.8 度の傾き・ぼかし・ノイズ・70% への縮小と拡大・紙の色・JPEG の圧縮(品質 55)を加えた画像です。OCR の実測表のスキャン風の画像と同じ加工です。この加工では、13 モデルとも、どちらの PDF でも加工前の画像との差があるとは言えませんでした。
スキャン風の画像より OCR の文字の方が正答がどちらの PDF でも多かったのは、Gemma 3 の 2 モデルと Mistral Small 3.2 24B で、画像と文字の比較で文字の方が多かった 3 モデルと同じです。ほかの 10 モデルは、どちらの PDF でも差があるとは言えませんでした。冒頭の罫線の無い表では、OCR の文字でも、どちらの PDF でも 6 モデルが 860 と答えました。OCR の文字でも、表の列の区切りが空白になるためと考えています(推定)。
本文の問いと表の問い(検定していない)
本文の問いと表の問いの正答率(画像と文字。検定していない)
| モデル | 画像・本文 | 画像・表 | 文字・本文 | 文字・表 |
|---|---|---|---|---|
| Gemma 4 26B | 95.9〜96.7 | 100.0 | 86.2〜91.1 | 100.0 |
| Qwen3.8 27B | 95.1〜96.7 | 96.8〜98.4 | 91.9〜92.7 | 98.4〜100.0 |
| Gemma 4 31B | 93.5〜95.1 | 100.0 | 90.2〜91.9 | 98.4〜100.0 |
| Qwen3.5 27B | 93.5〜95.1 | 98.4 | 91.1〜91.9 | 88.9〜93.7 |
| Qwen3-VL 32B Instruct | 92.7〜96.7 | 98.4 | 88.6〜92.7 | 93.7〜95.2 |
| Gemma 4 12B | 91.1〜95.1 | 100.0 | 85.4〜90.2 | 96.8〜98.4 |
| Qwen3.5 9B | 90.2 | 96.8 | 84.6〜86.2 | 84.1〜88.9 |
| Qwen3-VL 8B Instruct | 89.4〜90.2 | 93.7 | 83.7〜84.6 | 84.1〜85.7 |
| Qwen2.5-VL 7B | 82.9〜83.7 | 88.9〜92.1 | 69.9〜74.8 | 66.7〜71.4 |
| Qwen3-VL 30B-A3B Instruct | 76.4〜82.9 | 92.1〜93.7 | 85.4 | 82.5〜85.7 |
| Mistral Small 3.2 24B | 61.0〜68.3 | 90.5〜92.1 | 87.8〜89.4 | 88.9〜90.5 |
| Gemma 3 27B | 30.1〜53.7 | 82.5〜88.9 | 89.4〜90.2 | 93.7 |
| Gemma 3 12B | 30.1〜52.0 | 79.4〜82.5 | 89.4〜90.2 | 81.0 |
Gemma 3 の 2 モデルは、画像で渡した時の本文の問いの正答率が 30.1% から 53.7% で、表の問いの 79.4% から 88.9% より低い値でした。Gemma 3 は 100・150・200 dpi のどれでも入力が 349 トークンで、本文の小さい文字を読み取れていないためと考えています(推定)。
既存のベンチマークとの比較
日本語の文書を LLM や VLM に読ませる公開のベンチマークには、次のものがあります。
- Omni-JDocVQA(言語処理学会 第32回年次大会の予稿、2026年3月):多種の日本語の文書で作った質問応答 717 件で、公開されている 15 の VLM に文書の画像を直接渡して評価しています。採点は、GPT-5.1 が正解例と回答の一致を 5 段階で判定する方式です。取り出した文字や OCR の文字を渡す方法との比較は、予稿にはありませんでした。
- JDocQA(arXiv 2403.19454、LREC-COLING 2024):PDF 5,504 件と、日本語の質問応答 11,600 件のデータセットです。論文の評価では、PDF から取り出した文字(取り出せない PDF は OCR の文字)と質問をモデルに渡し、画像も読めるモデルには、ページの画像なども合わせて渡しています。
同じページ・同じ問い・同じモデルで、画像だけ・取り出した文字だけ・OCR の文字だけを渡して比べた日本語の公開のベンチマークは、編集部が 2026年11月14日に調べた範囲では見つけられませんでした(網羅的な調査ではありません)。この実測表は、採点に LLM の判定を使わず、正解に含まれる数字や語が答えの中にあるかの照合で決めています。
導入の前に確認すること
PDF を LLM に読ませる仕組みを作る前に、次の点の確認を勧めます。括弧の中は今回の測定での根拠です。
- 2 段組み・縦書き・罫線の無い表・セルの中で折り返した表を含む PDF では、取り出した文字の並びを確認する。(取り出した文字で根拠が見つからない問いでは、文字で渡した時の正答率が 13 モデルとも 73.3% 以下でした。罫線の無い表は、冒頭の 1 問の例です。)
- 画像で渡す時は、使うモデルで解像度ごとに測る。(100 dpi では Gemma 4 の 3 モデルと Qwen3-VL 30B-A3B Instruct の正答が、どちらの PDF でも少なくなり、Gemma 4 26B・31B はほぼ全問で「不明」と答えました。200 dpi は 150 dpi と、どちらの PDF でも差が出たモデルが無く、トークン数は最大で約 1.7 倍です。)
- Gemma 3 と Mistral Small 3.2 24B では、文字で渡す。(画像より文字の方が正答がどちらの PDF でも多かった 3 モデルです。)
- スキャンした PDF は、VLM に画像で渡す方法と、OCR してから渡す方法を、自社の書類で比べる。(スキャン風の画像で測ると、画像のまま渡すより OCR の文字の方が正答が多かったのは 3 モデルで、ほかの 10 モデルは差があるとは言えませんでした。本物のスキャンは測っていません。)
- 自社の PDF で測る。(文書のレイアウト・フォント・問いの種類が変われば、値は変わります。)
この実測表で分からないこと
- 複数のページを渡した時の値:渡したのは根拠のページ 1 ページだけです。文書の全体や、検索で選んだ複数のページを渡した時の値は分かりません。
- 図・グラフ・手書き:問いの根拠は、本文の文と表の値だけです。
- 本物のスキャン:スキャン風の画像は、加工前の画像を加工して作ったものです。実際にスキャンした書類の値は分かりません。
- 同じ PDF を測り直した時の揺れ:2 種類の PDF は作り方を変えたもので、同じ PDF の測り直しではありません。temperature 0 と seed は固定していますが、同じ PDF を繰り返し測った時の揺れは測っていません。
- 言い換えた答え:採点は、正解の数字の並びか語が答えの中にあるかで決めています。意味が同じでも、表記が違う答えは誤答です。たとえば正解が「21〜22分の1」(波ダッシュ「〜」)の問いで、全角チルダ「~」を使って「21~22分の1」と書いた答えは、見た目はほぼ同じでも誤答に数えました(「測定の条件」の節)。
- 画像のトークン数を決める仕組み:dpi とトークン数の関係は、Ollama が返したトークン数から読んだものです。各モデルが画像をどう縮小しているかは確認していません。Gemma 4 が「不明」と答えた原因も推定です。
- 時間とメモリ:測ってはいますが、共用の GPU 2 基に分けて実行したため、結論には使っていません。
- pdfplumber 以外の取り出し方:文字の取り出しは pdfplumber だけです。取り出し方ごとの違いは PDF 変換の実測表にあります。
測っていない対象と理由
- API で使うモデル(GPT・Gemini・Claude など):API キーと利用契約が必要なため、無料で使え、自社のサーバーで動かせるモデルに絞りました。
- glm-ocr 以外の OCR:今回の測定の環境では Ollama で動くモデルだけを使い、配布元のコードを動かす NDLOCR-Lite などの OCR は使っていません。OCR のツールごとの読み取りの精度は OCR の実測表にあります(NDLOCR-Lite も測っています)。
- Word・Excel から書き出した PDF:測った PDF は、LibreOffice と Chromium で作ったものだけです。
- Ollama 以外の実行環境と、ほかの量子化(重みの数値の精度を落として軽くする方式):Ollama 0.40.15 と、標準のタグで取得したモデル(量子化は全モデル Q4_K_M)だけです。
測定の条件
下の折りたたみを開くと、問いと PDF の作り方、渡し方ごとの条件、モデル、採点、検定の方法が表示されます。
測定の条件の詳細を開く
問いと PDF:PDF 変換の実測表の原稿 44 本(AIコンパスの公開済みの記事から作った横書き 40 本と、青空文庫の作品の縦書き 4 本)と、問い 201 問をそのまま使いました。PDF も同じもので、LibreOffice 26.8.2.2(python-docx で組んだ .docx を変換)と Chromium 140(Playwright の page.pdf、Noto Sans CJK JP)で作った PDF です。PDF は公開していません。
問いごとに根拠のページを 1 ページ決め、そのページだけを渡しました。決め方は、PDF の文字(pdfplumber と PyMuPDF で取り出し、NFKC で正規化して空白を除いたもの)の中で、本文の問いは根拠の文が、表の問いは行見出し・答えのセル・列見出しの全部が、同じページに見つかるページです。根拠のページの pdfplumber の文字に、根拠がそのままの形で見つからない問いを、「取り出した文字で根拠が見つからない問い」として、測定を始める前に分けました。根拠が 2 ページにまたがる 4 問(ページをまたぐ表)は外しました。残る 197 問のうち、文書を渡さずに質問だけを渡して 2 モデル以上が正解した 11 問も外し(除外の基準の 2)、集計の対象は 186 問(本文の問い 123・表の問い 63。縦書きの問い 9 を含む)です。
渡し方:
- 画像:PyMuPDF 2.1 で根拠のページを PNG にしました。150 dpi で 1,240〜1,241 × 1,754 画素、100 dpi で 827 × 1,170 画素、200 dpi で 1,653〜1,654 × 2,339 画素です。
- 文字:pdfplumber 0.11.10 の
extract_textで取り出した、根拠のページの文字です。正規化はせず、そのまま渡しました。Chromium の PDF の文字には、漢字の一部が見た目の同じ部首の文字(康熙部首。「日」が「⽇」になるなど)で入っていて、91 ページ中 87 ページにありました。LibreOffice の PDF では、この置き換わりは 0 ページでした。 - スキャン風の画像:150 dpi の画像を 0.8 度傾け、ぼかし(半径 0.6 のガウスぼかし)・ノイズ(標準偏差 8)・70% への縮小と拡大・紙の色を加え、JPEG(品質 55)で保存しました(Pillow 13.0.0)。OCR の実測表の加工と同じ処理です。
- OCR の文字:スキャン風の画像を、Ollama の glm-ocr(digest
89d735dd9c07)で文字にしました。プロンプトは「Text Recognition:」、temperature 0、seed 42、出力の上限 4,096、文脈の長さ 16,384 です。185 ページとも出力の上限に達していません。 - 文書なし:質問だけを渡しました(除外の基準の 2 に使いました)。
- 原稿の全文:PDF にする前の原稿の文字をそのまま渡しました。文字で読んだ時の上限の目安で、PDF の作り方に左右されないので 1 回だけ測りました。
プロンプトは、PDF 変換の実測表の段 3(変換した文書を LLM に渡して問いに答えさせる段)と同じです。「次の文書を読んで、質問に答えてください。答えだけを短く書いてください。文書から分からない時は「不明」と書いてください。」の後に、【文書】と【質問】を続けます。画像の時は【文書】の中を「(添付の画像)」と書き、画像は Ollama の images で渡しました。文書なしの時だけ、「次の質問に答えてください。答えだけを短く書いてください。分からない時は「不明」と書いてください。」の後に【質問】を続けます。
モデル:Ollama の /api/show が画像の入力(vision)に対応すると返した 13 モデルです。Ollama 0.40.15(Docker の公式イメージ ollama/ollama:latest、イメージ ID 0e59999e0e8f)の /api/chat で、temperature 0、seed 42、出力の上限(num_predict)128、文脈の長さ(num_ctx)16,384、同時の要求 4 です。思考(thinking)を止められるモデルは止めました。13 モデル × 2,758 回(197 問 × 渡し方 6 通り × PDF 2 種類 + 文書なしと原稿の全文 × 197 問)の応答で、エラー・出力の上限での打ち切り・思考の出力は 0 件でした。渡し方 6 通りは、冒頭の 4 通りに 100 dpi と 200 dpi の画像を足したものです。
測ったモデル
| モデル | 開発元 | パラメータ数 | digest | 思考の設定 |
|---|---|---|---|---|
| Gemma 4 26B | 25.2B | 001e5dafc3c7 | 思考を止めた(think=false) | |
| Qwen3.8 27B | Alibaba | 27.3B | aaee06c39dcf | 思考を止めた(think=false) |
| Gemma 4 31B | 30.7B | 17ba34c06c80 | 思考を止めた(think=false) | |
| Qwen3.5 27B | Alibaba | 26.9B | 64ae5b1d651f | 思考を止めた(think=false) |
| Qwen3-VL 32B Instruct | Alibaba | 33.4B | c9a60b1a1a13 | 指定なし |
| Gemma 4 12B | 11.9B | 6114515d63c1 | 思考を止めた(think=false) | |
| Qwen3.5 9B | Alibaba | 9.0B | 56671c2ab938 | 思考を止めた(think=false) |
| Qwen3-VL 8B Instruct | Alibaba | 8.2B | 70e58e37beb1 | 指定なし |
| Qwen2.5-VL 7B | Alibaba | 8.3B | 5ced39dfa4ba | 指定なし |
| Qwen3-VL 30B-A3B Instruct | Alibaba | 30.5B | 9b053ed92b6a | 指定なし |
| Mistral Small 3.2 24B | Mistral AI | 24.0B | 5a408ab55df5 | 指定なし |
| Gemma 3 27B | 27.0B | 6be2e2ba6843 | 指定なし | |
| Gemma 3 12B | 11.8B | b92b218582c5 | 指定なし |
採点:規則だけで判定しました。判定役の LLM は使っていません。PDF 変換の実測表の段 3 と同じ規則です。
- 正解が数の問い:正解の中の数の並び(「3,700万」なら 3700)が、答えの中の数の並びに、同じ順で続けて出てくれば正解です。桁区切りのカンマは除いて比べます。
- 正解が数でない問い:NFKC で正規化して空白を除いた正解が、同じく正規化した答えの中にあれば正解です。
- 「不明」「分かりません」などを含む答えは「不明」と数え、誤答に入れました。
- 正解が「a/b」の形の問い(186 問中 15 問)は、a と b の両方が、この順で答えの中にある時だけ正解にしました。
意図と違う判定になった採点が 1 つあります。正解が「21〜22分の1」(波ダッシュ)の 1 問で、「21~22分の1」(全角チルダ。NFKC で半角の「~」になる)と書いた答えは、正解の語と一致しないので誤答になりました。この形の正解は 197 問中この 1 問だけです。波ダッシュとチルダを同じ文字として採点し直すと、誤答から正解に変わる応答は 28 件(OCR の文字 13・200 dpi 5・150 dpi の画像 4・100 dpi 3・スキャン風の画像 3。どのモデルと条件でも 1 件以下)です。どちらの PDF でも差が出た組の判定は、5 組 × 13 モデルで変わりません。変わるのは 1 か所で、Qwen3-VL 8B Instruct の画像と文字の LibreOffice の PDF で、補正後の p が 0.096 から 0.039 になり、「差があるとは言えない」から「片方の PDF だけで差が出た」に移ります。測定を始める前に決めた採点のまま載せています。
除外の基準:測定を始める前に、次の 3 つを決めました。
- 根拠が 1 ページに収まらない問いは外します(4 問)。
- 文書なしで 13 モデル中 2 モデル以上が正解した問いは、集計の対象から外します(11 問)。文書を読まずに答えられる問いと見なします。
- 接続の失敗などで応答が返らなかった問いは測り直し、測り直しても返らなければ分母から外します。該当する応答はありませんでした。
差の判定:2 つの渡し方を、同じ問いで比べる符号検定(二項分布による正確検定、両側)で調べました。片方の渡し方だけで正解した問いを数え、その数を比べます。比べた組は、画像と文字、スキャン風の画像と OCR の文字、画像とスキャン風の画像、100 dpi と 150 dpi、200 dpi と 150 dpi の 5 つです。13 モデルを同時に調べると、本当は差が無いのに差があると判定する誤りが増えるので、組と PDF ごとに、モデルの数で Holm 法の補正をかけました。この検定は 2 種類の PDF で別々に行い、どちらでも補正後の p が 0.05 未満で、向きも同じ時だけ「どちらの PDF でも多かった」「どちらの PDF でも少なかった」と書きます。片方の PDF だけで p が 0.05 未満だった時は「片方の PDF だけで差が出た」としてモデルの名前を挙げ、どちらでも 0.05 未満でなければ「差があるとは言えない」と書きます。5 組 × 13 モデルのうち、片方の PDF だけで差が出たのは、画像と文字の Gemma 4 26B の 1 か所です。モデルどうしの差と、取り出した文字で根拠が見つからない問い・本文と表の問いに分けた集計は、検定していません。
検定の一覧(比べた組・モデルごと)
| モデル | 画像と文字 | スキャンと OCR | 画像とスキャン | 100 dpi と 150 dpi | 200 dpi と 150 dpi |
|---|---|---|---|---|---|
| Gemma 4 26B | Chromium だけ画像が多い p 0.584・0.009 9/3・14/1 | 差があるとは言えない p 1.000・1.000 2/7・6/6 | 差があるとは言えない p 1.000・1.000 6/3・4/1 | どちらでも150dpiが多い p 0.001未満・0.001未満 0/180・0/182 | 差があるとは言えない p 1.000・1.000 3/2・2/2 |
| Qwen3.8 27B | 差があるとは言えない p 0.584・1.000 9/3・7/6 | 差があるとは言えない p 1.000・1.000 1/6・1/4 | 差があるとは言えない p 1.000・1.000 3/2・1/4 | 差があるとは言えない p 1.000・0.281 1/2・1/8 | 差があるとは言えない p 1.000・1.000 0/1・5/2 |
| Gemma 4 31B | 差があるとは言えない p 0.523・1.000 9/2・6/4 | 差があるとは言えない p 1.000・1.000 3/6・4/6 | 差があるとは言えない p 1.000・1.000 3/3・3/4 | どちらでも150dpiが多い p 0.001未満・0.001未満 0/180・0/177 | 差があるとは言えない p 1.000・1.000 3/2・4/2 |
| Qwen3.5 27B | 差があるとは言えない p 0.584・0.059 9/4・13/2 | 差があるとは言えない p 1.000・1.000 4/6・9/7 | 差があるとは言えない p 1.000・1.000 1/4・3/2 | 差があるとは言えない p 1.000・0.714 2/5・4/9 | 差があるとは言えない p 1.000・1.000 4/0・4/1 |
| Qwen3-VL 32B Instruct | 差があるとは言えない p 0.529・0.668 12/4・13/6 | 差があるとは言えない p 1.000・1.000 4/4・5/6 | 差があるとは言えない p 1.000・1.000 2/3・3/5 | 差があるとは言えない p 1.000・0.547 2/5・2/8 | 差があるとは言えない p 1.000・1.000 2/4・7/4 |
| Gemma 4 12B | 差があるとは言えない p 0.529・0.176 10/3・12/3 | 差があるとは言えない p 1.000・1.000 6/7・8/12 | 差があるとは言えない p 1.000・1.000 2/1・5/2 | どちらでも150dpiが多い p 0.001未満・0.001未満 3/26・0/48 | 差があるとは言えない p 1.000・1.000 2/2・5/3 |
| Qwen3.5 9B | 差があるとは言えない p 0.529・0.117 18/8・25/10 | 差があるとは言えない p 1.000・1.000 10/10・11/10 | 差があるとは言えない p 1.000・1.000 3/3・3/2 | 差があるとは言えない p 0.347・0.066 2/10・2/13 | 差があるとは言えない p 1.000・1.000 5/5・3/2 |
| Qwen3-VL 8B Instruct | 差があるとは言えない p 0.096・0.136 18/5・18/6 | 差があるとは言えない p 1.000・1.000 9/7・13/10 | 差があるとは言えない p 1.000・1.000 1/2・3/5 | 差があるとは言えない p 1.000・0.281 4/5・7/18 | 差があるとは言えない p 1.000・1.000 2/0・5/4 |
| Qwen2.5-VL 7B | どちらでも画像が多い p 0.001未満・0.001未満 29/5・38/8 | 差があるとは言えない p 1.000・1.000 22/21・24/21 | 差があるとは言えない p 1.000・1.000 10/4・9/3 | 差があるとは言えない p 1.000・0.281 2/6・3/12 | 差があるとは言えない p 1.000・1.000 4/4・5/2 |
| Qwen3-VL 30B-A3B Instruct | 差があるとは言えない p 0.690・1.000 14/11・14/20 | 差があるとは言えない p 0.070・0.201 8/24・11/26 | 差があるとは言えない p 1.000・1.000 10/5・9/7 | どちらでも150dpiが多い p 0.001未満・0.001未満 3/32・3/37 | 差があるとは言えない p 1.000・1.000 7/4・7/7 |
| Mistral Small 3.2 24B | どちらでも文字が多い p 0.001未満・0.001未満 6/31・7/39 | どちらでもOCRが多い p 0.001未満・0.001未満 6/37・9/45 | 差があるとは言えない p 1.000・1.000 10/12・17/18 | 差があるとは言えない p 1.000・0.714 8/6・9/5 | 差があるとは言えない p 1.000・1.000 6/5・9/5 |
| Gemma 3 27B | どちらでも文字が多い p 0.001未満・0.001未満 5/57・4/80 | どちらでもOCRが多い p 0.001未満・0.001未満 7/70・7/90 | 差があるとは言えない p 1.000・1.000 18/15・16/14 | 差があるとは言えない p 1.000・0.547 12/11・15/7 | 差があるとは言えない p 1.000・1.000 5/10・13/10 |
| Gemma 3 12B | どちらでも文字が多い p 0.001未満・0.001未満 14/60・9/83 | どちらでもOCRが多い p 0.001未満・0.001未満 12/76・10/92 | 差があるとは言えない p 1.000・1.000 26/16・15/14 | 差があるとは言えない p 1.000・0.714 13/12・6/12 | 差があるとは言えない p 1.000・1.000 12/15・9/5 |
実行の方法:共用の計算サーバーの GPU(NVIDIA H200)2 基に Ollama を 1 つずつ置き、モデルを分担して実行しました。応答が止まった時は、Ollama を再起動して同じモデルを続きから実行する決まりにし、4 回再起動しました。再起動の前に得た応答は、再起動の後に同じ問いで取り直した応答に置き換えています。
拡大した画像で追加した測定:Gemma 4 26B・31B が 100 dpi でほぼ全問に「不明」と答えたことは、測定の途中で分かりました。その時点で、2 つを決めました。1 つは、100 dpi の画像を 150 dpi の画像と同じ画素数へ BICUBIC で拡大した画像を、Gemma 4 の 3 モデルに LibreOffice の PDF の全問で渡す測定の追加です。もう 1 つは読み方で、拡大で正答が 150 dpi 並みに戻れば「画素数の少ない画像の扱いが原因」、戻らなければ「100 dpi で読める情報が失われた」と読みます。この測定は、すべての測定が終わった後に実行し、検定には入れていません。
編集部の作業と LLM:問いの根拠のページの決め方、採点の規則の決定、応答の読み直し、冒頭の例の選択など、この記事で「編集部が決めた」「選んだ」「読んだ」と書いた作業には、LLM(Anthropic の Claude)を使いました。人による読み直しはしていません。
図の値の表:図の値は次の表のとおりです。
画像で渡した時の方が正答がどちらの PDF でも多かったモデルは 13 モデル中 1 モデル(Qwen2.5-VL 7B)、文字で渡した時の方がどちらの PDF でも多かったモデルは 3 モデル(Gemma 3 12B・Gemma 3 27B・Mistral Small 3.2 24B)
| モデル | 画像(150 dpi) | 文字(pdfplumber) | 原稿の全文 |
|---|---|---|---|
| Gemma 4 26B | 97.3〜97.8 | 90.9〜94.1 | 97.3 |
| Qwen3.8 27B | 95.7〜97.3 | 94.1〜95.2 | 99.5 |
| Gemma 4 31B | 95.7〜96.8 | 93.0〜94.6 | 97.3 |
| Qwen3.5 27B | 95.2〜96.2 | 90.3〜92.5 | 97.3 |
| Qwen3-VL 32B Instruct | 94.6〜97.3 | 90.9〜93.0 | 97.8 |
| Gemma 4 12B | 94.1〜96.8 | 89.2〜93.0 | 97.3 |
| Qwen3.5 9B | 92.5 | 84.4〜87.1 | 94.6 |
| Qwen3-VL 8B Instruct | 90.9〜91.4 | 84.4 | 90.3 |
| Qwen2.5-VL 7B | 84.9〜86.6 | 68.8〜73.7 | 79.6 |
| Qwen3-VL 30B-A3B Instruct | 82.3〜86.0 | 84.4〜85.5 | 95.7 |
| Mistral Small 3.2 24B | 71.5〜75.8 | 88.7〜89.2 | 95.7 |
| Gemma 3 27B | 50.0〜63.4 | 90.9〜91.4 | 97.3 |
| Gemma 3 12B | 46.8〜62.4 | 86.6〜87.1 | 95.7 |
取り出した文字で根拠が見つからない問いでは、文字で渡した時の正答率が 13 モデルとも 73.3% 以下。画像ではどちらの PDF でも 80% 以上のモデルが 5 モデル(検定していない)
| モデル | 画像(150 dpi) | 文字(pdfplumber) |
|---|---|---|
| Gemma 4 26B | 90.0〜93.1 | 56.7〜65.5 |
| Qwen3.8 27B | 86.7〜93.1 | 69.0〜70.0 |
| Gemma 4 31B | 83.3〜89.7 | 62.1〜73.3 |
| Qwen3.5 27B | 75.9〜80.0 | 60.0〜65.5 |
| Qwen3-VL 32B Instruct | 80.0〜89.7 | 56.7〜65.5 |
| Gemma 4 12B | 73.3〜89.7 | 50.0〜58.6 |
| Qwen3.5 9B | 75.9〜83.3 | 40.0〜48.3 |
| Qwen3-VL 8B Instruct | 80.0〜89.7 | 48.3〜56.7 |
| Qwen2.5-VL 7B | 48.3〜53.3 | 30.0〜34.5 |
| Qwen3-VL 30B-A3B Instruct | 53.3〜58.6 | 44.8〜50.0 |
| Mistral Small 3.2 24B | 40.0〜55.2 | 58.6〜63.3 |
| Gemma 3 27B | 30.0〜44.8 | 58.6〜63.3 |
| Gemma 3 12B | 30.0〜34.5 | 53.3〜55.2 |
100 dpi の画像で、150 dpi より正答がどちらの PDF でも少なかったモデルは 4 モデル(Gemma 4 12B・Gemma 4 26B・Gemma 4 31B・Qwen3-VL 30B-A3B Instruct)。200 dpi と 150 dpi で、どちらの PDF でも差が出たモデルは 0(13 モデル中)
| モデル | 画像(100 dpi) | 画像(150 dpi) | 画像(200 dpi) |
|---|---|---|---|
| Gemma 4 26B | 0.0〜0.5 | 97.3〜97.8 | 97.8 |
| Qwen3.8 27B | 91.9〜96.8 | 95.7〜97.3 | 96.8〜97.3 |
| Gemma 4 31B | 0.0〜0.5 | 95.7〜96.8 | 96.8〜97.3 |
| Qwen3.5 27B | 93.5 | 95.2〜96.2 | 97.3〜97.8 |
| Qwen3-VL 32B Instruct | 91.4〜95.7 | 94.6〜97.3 | 96.2 |
| Gemma 4 12B | 68.3〜84.4 | 94.1〜96.8 | 95.2〜96.8 |
| Qwen3.5 9B | 86.6〜88.2 | 92.5 | 92.5〜93.0 |
| Qwen3-VL 8B Instruct | 84.9〜90.9 | 90.9〜91.4 | 91.4〜92.5 |
| Qwen2.5-VL 7B | 80.1〜84.4 | 84.9〜86.6 | 86.6 |
| Qwen3-VL 30B-A3B Instruct | 64.0〜70.4 | 82.3〜86.0 | 82.3〜87.6 |
| Mistral Small 3.2 24B | 73.7〜76.9 | 71.5〜75.8 | 73.7〜76.3 |
| Gemma 3 27B | 54.3〜64.0 | 50.0〜63.4 | 51.6〜60.8 |
| Gemma 3 12B | 43.5〜62.9 | 46.8〜62.4 | 48.9〜60.8 |
スキャン風の画像と比べて、OCR の文字の方が正答がどちらの PDF でも多かったモデルは 13 モデル中 3 モデル(Gemma 3 12B・Gemma 3 27B・Mistral Small 3.2 24B)。加工前の画像とスキャン風の画像で、どちらの PDF でも差が出たモデルは 0
| モデル | スキャン風の画像 | OCR の文字 | 加工前の画像(150 dpi) |
|---|---|---|---|
| Gemma 4 26B | 95.7〜96.2 | 96.2〜98.4 | 97.3〜97.8 |
| Qwen3.8 27B | 96.8〜97.3 | 98.9〜99.5 | 95.7〜97.3 |
| Gemma 4 31B | 96.2〜96.8 | 97.3〜98.4 | 95.7〜96.8 |
| Qwen3.5 27B | 95.7〜96.8 | 94.6〜97.8 | 95.2〜96.2 |
| Qwen3-VL 32B Instruct | 95.7〜97.8 | 96.2〜97.8 | 94.6〜97.3 |
| Gemma 4 12B | 92.5〜96.2 | 94.6〜96.8 | 94.1〜96.8 |
| Qwen3.5 9B | 91.9〜92.5 | 91.4〜92.5 | 92.5 |
| Qwen3-VL 8B Instruct | 91.9 | 90.3〜90.9 | 90.9〜91.4 |
| Qwen2.5-VL 7B | 81.7〜83.3 | 80.1〜82.8 | 84.9〜86.6 |
| Qwen3-VL 30B-A3B Instruct | 81.2〜83.3 | 89.2〜91.9 | 82.3〜86.0 |
| Mistral Small 3.2 24B | 72.0〜76.9 | 91.4〜93.5 | 71.5〜75.8 |
| Gemma 3 27B | 48.9〜61.8 | 93.5〜95.7 | 50.0〜63.4 |
| Gemma 3 12B | 46.2〜57.0 | 90.3〜91.4 | 46.8〜62.4 |
公開データは、モデル・渡し方・PDF ごとの正答の数と、検定の結果です(results.json)。問いは PDF 変換の実測表の公開データ(questions.json)と同じです。PDF、測定のスクリプト、モデルごとの生の応答は公開していません。
よくある質問
PDF を LLM に読ませる時、ページを画像で渡すのと、文字を取り出して渡すのとでは、どちらが正答が多いですか。
モデルによります。編集部の測定(2026年11月、Ollama で動く 13 モデル、186 問、作り方の違う 2 種類の PDF)では、正答の数に、どちらの PDF でも検定で差が出たのは 4 モデルでした。画像の方が多かったのは Qwen2.5-VL 7B、文字(pdfplumber で取り出した文字)の方が多かったのは Gemma 3 12B・Gemma 3 27B・Mistral Small 3.2 24B です。Gemma 4 26B は、Chromium で作った PDF だけで画像の方が多い結果でした。残る 8 モデルは、どちらの PDF でも差があるとは言えませんでした。ただし、取り出した文字で根拠が見つからない問い(2 段組み・縦書き・セルの中で折り返した表)に限ると、文字で渡した時の正答率は 13 モデルとも 73.3% 以下で、画像では 5 モデルがどちらの PDF でも 80% 以上でした(この分け方では検定していません)。
日本語の PDF を画像で読ませるなら、ローカルで動くどの VLM がよいですか。
どのモデルが最もよいかは、この測定では決められません。モデルどうしの差は検定していないためです。画像(150 dpi)で渡した時の正答率が、作り方の違う 2 種類の PDF のどちらでも 90.9% 以上だったのは 8 モデル(Gemma 4 12B・Gemma 4 26B・Gemma 4 31B・Qwen3-VL 32B Instruct・Qwen3-VL 8B Instruct・Qwen3.5 27B・Qwen3.5 9B・Qwen3.8 27B)で、8 モデルの値は 90.9% から 97.8% でした。Gemma 3 の 2 モデルは 46.8% から 63.4% でした。使う文書で測ることを勧めます。
PDF を画像にする時の解像度は、何 dpi にすればよいですか。
測った 3 通りでは、150 dpi と 200 dpi で、正答の数に作り方の違う 2 種類の PDF のどちらでも差が出たモデルはありませんでした(13 モデル中)。100 dpi では 4 モデル(Gemma 4 12B・Gemma 4 26B・Gemma 4 31B・Qwen3-VL 30B-A3B Instruct)の正答が、150 dpi よりどちらの PDF でも少なくなりました。200 dpi では、Qwen3-VL・Qwen3.5・Qwen3.8 の入力のトークン数が 150 dpi の約 1.7 倍(約 2,230 から約 3,880)になります。
Gemma 4 に 100 dpi の PDF の画像を渡すと「不明」と答えるのはなぜですか。
編集部の測定では、100 dpi の画像(A4 で 827 × 1,170 画素)を渡すと、Gemma 4 26B は 186 問中 185〜186 問、Gemma 4 31B は 179〜184 問で「不明」と答えました(作り方の違う 2 種類の PDF の値)。同じ 100 dpi の画像を 150 dpi と同じ画素数へ拡大して渡すと、Gemma 4 の 3 モデルは 186 問中 177 問から 182 問に正解しました(LibreOffice で作った PDF で測定。150 dpi では 180 問から 181 問)。拡大しても読める情報は増えません。このため、読めなかった原因は画像の中身ではなく、画素数の少ない画像を少ないトークン(約 490)にして読む処理にあると考えています(推定。Ollama とモデルのどちらの処理かは確認していません)。
スキャンした PDF は、OCR で文字にしてから渡すのと、画像のまま VLM に渡すのとでは、どちらがよいですか。
スキャン風に加工した画像で測ると、OCR(glm-ocr)で文字にしてから渡した方が、画像のまま渡すより正答が、作り方の違う 2 種類の PDF のどちらでも多かったのは 3 モデル(Gemma 3 12B・Gemma 3 27B・Mistral Small 3.2 24B)でした。ほかの 10 モデルは、どちらの PDF でも差があるとは言えませんでした。加工前の画像とスキャン風の画像では、正答の数にどちらの PDF でも差が出たモデルはありませんでした。本物のスキャンは測っていません。